您现在的位置是:热点 >>正文
标签: DeepSeek DeepSeek-OCR 2 OCR模型 文档识别
热点148248人已围观
简介...
云梦级1月27日云梦级消息,DeepSeek 今日公布了其最新一代文档识别模型 DeepSeek-OCR 2。很显然,该模型是在 DeepSeek-OCR 的基础上升级而来,核标签心变化集中在视觉编码器设计上。
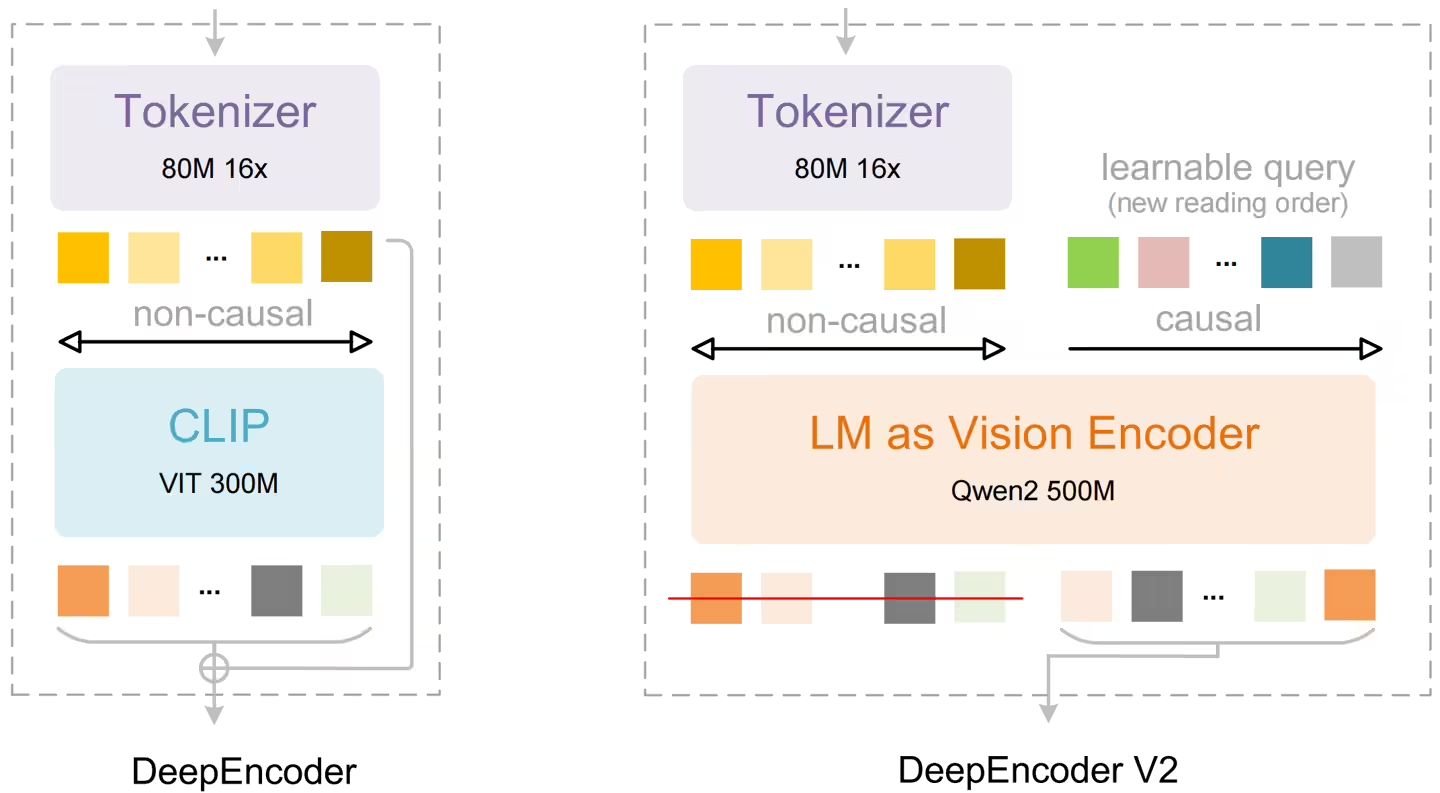
研究团队提出了一种名为 DeepEncoder V2 的新型编码器结构,它能够根据图像语义动态调整视觉信息的处理顺序,使模型在进行文字识别前先对视觉内: 容进行智能排序。这项技术突破源于对传统视觉语言模型处理方式的重新思考,旨在让机器更贴近人类的视觉阅读逻辑。
在传统的视觉语言模型中,图像通常会被切分为若干视觉 token,并按照De从左上到右下的固定栅格顺序送入模型处理。这种方式虽然实现简单,但与人类在阅读文档、表格或公式时基于语义和逻辑关系进行跳跃式浏览的方式并不一致。
DeepSeek 论文指出,ep尤其在版式复杂的文档场景中,视觉元素之间往往存在明确的逻辑先后关系,仅依赖空间顺序可能限制模型对内容结构的理解能力。
DeepSeek-OCR 2 的改进重点在于引入“视觉因果流”的Se概念。在 DeepEncoder V2 中,研究团队用一种类语言模型结构替代了原先基于 CLIP 的视觉编码模块,并在编码器内部引入可学习的“因果流查询 token”。
其编码器同时包含双ek向注意力与因果注意力两种处理模式,原始视觉信息通过双向注意力进行全局感知,而新增的查询标记则通过因果注意力逐步建立语义顺序,从而在编码阶段对视觉 token 的顺序进行动态重排。 D最终,只有经过因果重排后的查询 token 会被送入后续的解码器,用于生成识别结果。
在整体架构上,DeepSeek-OCR 2 仍沿用了前代模型的编解码框架。编码器将图像转换为ee视觉标记并进行压缩,被压缩为较少数量的视觉 token,再由 DeepEncoder V2 进行语义建模和顺序重组,最后交由一个基于混合专家架构(MoE)的语言模型解码。
DeepSpSeek 论文指出,该设计在不显著增加解码负担的前提下,将单页文档所使用的视觉 token 数量控制在 256 到 1120 之间,与前代模型及同类系统的资源开销保持在相近水平。
为验证模ee型性能,研究团队在 OmniDocBench v1.5 基准上进行了全面评估。该基准涵盖多种类型的中英文文档,包括学术论文、杂志、报告等,重点考察文本识别、公式解析、表格结构还k-原以及阅读顺序等指标。
测试结果显示,在视觉 token 上限更低的情况下,DeepSeek-OCR 2 的整体得分达到 91.09%,相较 DeepSeek-OCR 提升了 3.73OC%。特别是在阅读顺序准确度方面,编辑距离从 0.085 降至 0.057,表明新模型能够更合理地理解文档内容结构。
DeepSeek-OCR 2 在生产环境中也表现出更好的稳定性。在线R 用户日志图像的重复率从 6.25% 降至 4.17%,批处理 PDF 数据的重复率从 3.69% 降至 2.88%。这些改进使得模型在保持高压缩率的同时,提升了实际应用场景中的可靠性。
Tags:
上一篇:妈咪手是什么梗exo
相关文章
IBM达到磁带存储的里程碑,概述了磁带在混合云未来中的作用
热点数据以物理形式存在了数千年,一直追溯到洞穴壁画,在那里原始文明发明了保存部落记忆的方法。人类对知识的追求,以及随之而来的数据的不可阻挡的指数级增长,要求越来越复杂的方式来存储、保护和检索信息。尽管新技...
【热点】
阅读更多微软高管解读Q3财报:年底仍会存在供应短缺 但持乐观态度
热点微软发布2025财年第三财季财报:营收为700.66亿美元,同比增长13%,不计入汇率变动的影响为同比增长15%;净利润为258.24亿美元,同比增长18%,不计入汇率变动的影响为同比增长19%。 微...
【热点】
阅读更多自研 Pulsar Starter:Winfun-Pulsar-Spring-Boot-Starter
热点里程碑 版本 功能点 作者 完成 1.0.0 支持PulsarTemplate发送消息&支持自定义注解实例化Consumer监听消息 howinfun 1.1.0 支持动态开启/关闭Consumer消...
【热点】
阅读更多