您现在的位置是:热点 >>正文
标签: GLM-5.1 智谱 开源大模型 SWE-bench-Pro
热点107人已围观
简介...
云梦级4月8日云梦级消息,智谱今日正式发布新一代开源模型 GLM-5.1,官方称这是目前全球最强的开源模型。据官方标签介绍,其是唯一达到 8 小时级持续工作的开源模型,在最接近真实软件开发的 SWE-bench Pro 基准测试中,GLM-: 5.1 实现国产模型首次超越 Opus 4.6。
OpenRouter 显示,伴随此次发布,智谱 GLM 再度提价 10%。调价后,GLGLM-5.1 在 Coding 场景的缓存命中 Token 价格已接近 Anthropic 旗下 Claude Sonnet4.6 水平。M-这是国产大模型首次在核心场景实现与海外头部厂商的价格对齐。
官方详细介绍如下:
从 3 分钟的 Vibe Coding(氛围编5.程)到 30 分钟的 Agentic Engineering(智能体工程),再到本次我们带来的 8 小时 Long-Horizo1 n Task(长程任务),GLM-5.1 再次取得突破。
GLM-5.1 是我们迄今最智能的旗舰模型,也是目前全球最强的开源模智谱型。GLM-5.1 大大提高了代码能力,在完成长程任务方面提升尤为显著。和此前分钟级交互的模型不同,它能够在一次任务 开中独立、持续工作超过 8 小时,期间自主规划、执行、自我进化,最终交付完整的工程级成果。
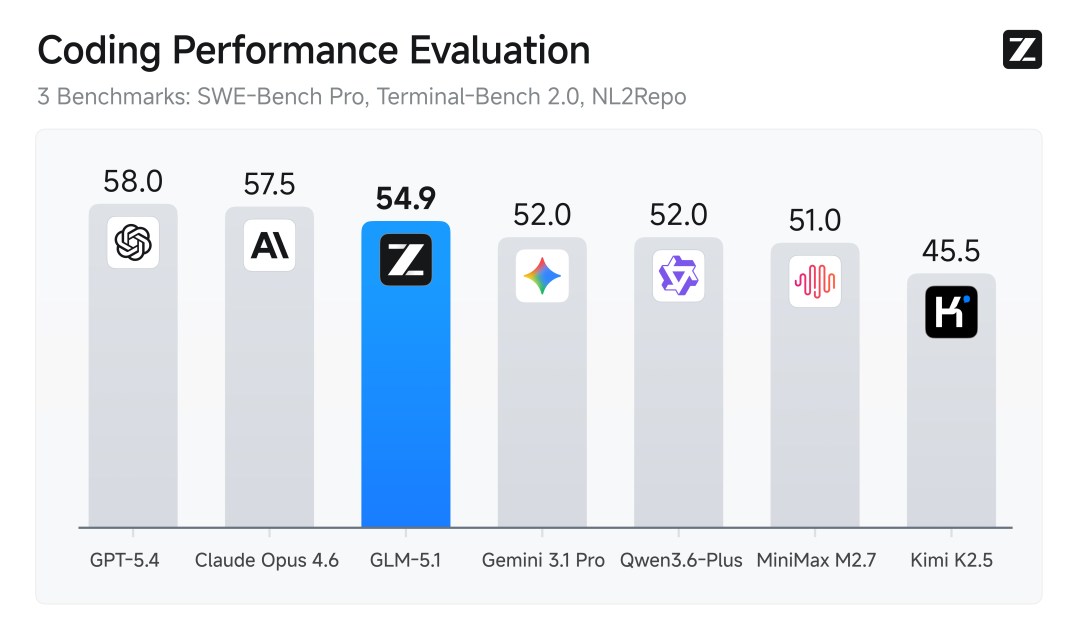
代码能力是模型智能水平进一步提源大升的关键。下图是业内最具代表性的三个代码评测基准的平均结果,包括衡量模型专业软件开发工作的 SWE-Bench Pro、模型操作命令行解决问题的 Terminal-Bench 2.0、从零构建完整代码仓库的 NL2Repo,GLM-5.1 取得全球 S模型第三、国产模型第一、开源模型第一。

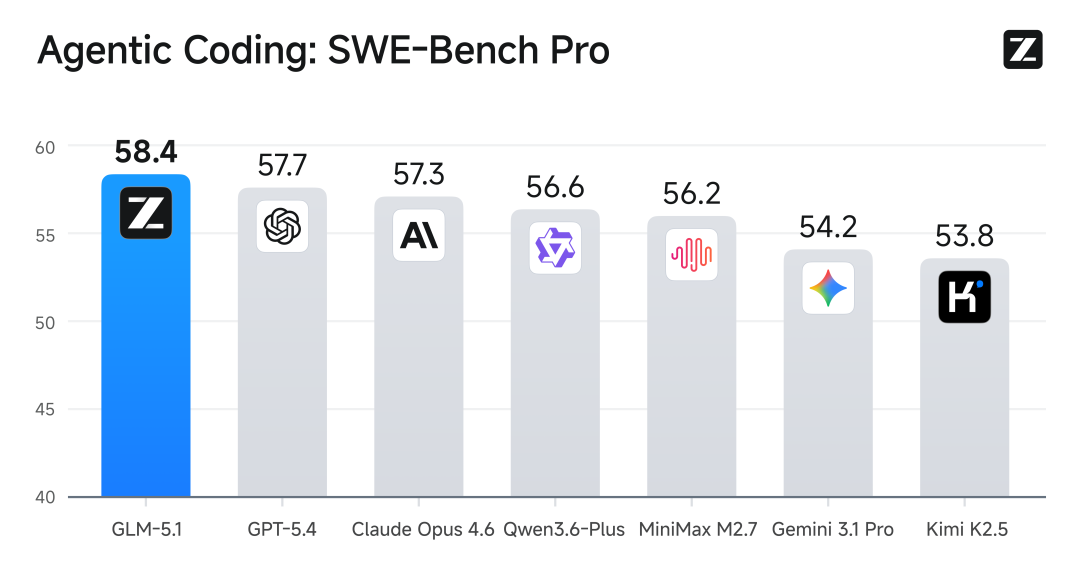
在最接近真实软件开发的 SWE-bench Pro 基准测试中,GLM-5.1 刷新全球最WE佳成绩,超过 GPT-5.4、Claude Opus 4.6。SWE-Bench Pro 要求模型在真实 GitHub 仓库中定位并修复-b高难度工程 Bug,是衡量模型能否胜任专业软件开发的最硬指标。
Tags:
相关文章
标签: 爱奇艺 银河综艺馆
热点2025爱奇艺尖叫之夜于近日在中国澳门银河综艺馆圆满落幕,这场年度娱乐盛典的收官不仅为爱奇艺与澳门银河综艺馆为期三年的首次合作画上圆满句号,也成为双方续写合作新篇的重要契机——12月9日,双方正式宣布...
【热点】
阅读更多标签: 英伟达 英特尔 NVLink Xeon
热点云梦级12月30日云梦级消息,英伟达正式完成了对英特尔价值 50 亿美元的股权认购,以每股 23.28 美元的价格购入了约 2.147 亿股普通股。这笔交易不仅是英伟达履行其在今年 9 月份达成的 S...
【热点】
阅读更多用自洽性提升大模型推理能力,谷歌解答基准中75%数学问题,比GPT-3提升20%
热点尽管语言模型在一系列 NLP 任务中取得了显著的成功,但它们的推理能力往往不足,仅靠扩大模型规模不能解决这个问题。基于此,Wei et al. (2022) 提出了思维提示链(chain of tho...
【热点】
阅读更多